write
R2026b将 tall 数组写入本地和远程位置以设置检查点
描述
write( 使用 filepattern,tA)filepattern 中的文件扩展名来确定输出格式。filepattern 必须包含要写入文件的文件夹,后跟包含通配符 * 的文件名。通配符表示递增编号,用于生成唯一文件名。例如,write('folder/myfile_*.csv',tA)。
write(___, 支持任何上述语法,且可使用一个或多个名称-值对组参量指定其他选项。例如,您可以使用 Name,Value)'FileType' 指定文件类型,并指定有效的文件类型('mat'、'seq'、'parquet'、'text' 或 'spreadsheet'),您也可以使用 'WriteFcn' 和函数句柄指定自定义写函数来处理数据。
示例
将 tall 数组写入磁盘,然后通过为写入的文件创建新数据存储来恢复该 tall 数组。此过程对于保存您的工作或与同事共享 tall 数组非常有用。
为 airlinesmall.csv 数据集创建数据存储。仅选择 Year、Month 和 UniqueCarrier 变量,并将 'NA' 值视为缺失数据。将数据存储转换为 tall 表。
ds = datastore('airlinesmall.csv');
ds.TreatAsMissing = 'NA';
ds.SelectedVariableNames = {'Month','Year','UniqueCarrier'};
tt = tall(ds)
tt =

  M×3 tall table

    Month    Year    UniqueCarrier
    _____    ____    _____________

     10      1987       {'PS'}
     10      1987       {'PS'}
     10      1987       {'PS'}
     10      1987       {'PS'}
     10      1987       {'PS'}
     10      1987       {'PS'}
     10      1987       {'PS'}
     10      1987       {'PS'}
      :       :            :
      :       :            :
按照年的降序对数据排序,然后提取前 25 行。生成的 tall 表是未经计算的。
tt_new = topkrows(tt,25,'Year')tt_new =
M×3 tall table
Month Year UniqueCarrier
_____ ____ _____________
? ? ?
? ? ?
? ? ?
: : :
: : :
Preview deferred. Learn more.
将结果保存到 C:\ 盘上名为 ExampleData 的新文件夹。(您可以指定不同的写入位置,特别是当您使用的不是 Windows® 计算机时。)write 函数在写入文件前计算 tall 数组,因此无需在保存数据前使用 gather 函数。
location = 'C:\ExampleData';
write(location,tt_new)
Writing tall data to folder C:\ExampleData Evaluating tall expression using the Local MATLAB Session: - Pass 1 of 1: Completed in 0.25 sec Evaluation completed in 0.65 sec
从工作目录中清除 tt 和 ds。要恢复已写入磁盘的 tall 表,请先创建引用相同目录的新数据存储。然后将该数据存储转换为 tall 表。由于在将 tall 表写入磁盘前已对其进行计算,因此显示中现在包含值的预览。
clear tt ds
ds2 = datastore(location);
tt2 = tall(ds2)
tt2 =

  M×3 tall table

    Month    Year    UniqueCarrier
    _____    ____    _____________

      1      2008       {'WN'}
      1      2008       {'WN'}
      1      2008       {'WN'}
      1      2008       {'WN'}
      1      2008       {'WN'}
      1      2008       {'WN'}
      1      2008       {'WN'}
      1      2008       {'WN'}
      :       :            :
      :       :            :
创建一个引用 tsunamis.xlsx 数据文件的 tall 表,其中包含有关海啸的位置、量级和原因的时间戳数据。
ds = spreadsheetDatastore('tsunamis.xlsx');
T = tall(ds)
T =
M×20 tall table
Latitude Longitude Year Month Day Hour Minute Second ValidityCode Validity CauseCode Cause EarthquakeMagnitude Country Location MaxHeight IidaMagnitude Intensity NumDeaths DescDeaths
________ _________ ____ _____ ___ ____ ______ ______ ____________ _________________________ _________ __________________ ___________________ ___________________ __________________________ _________ _____________ _________ _________ __________
-3.8 128.3 1950 10 8 3 23 NaN 2 {'questionable tsunami' } 1 {'Earthquake' } 7.6 {'INDONESIA' } {'JAVA TRENCH, INDONESIA'} 2.8 1.5 1.5 NaN NaN
19.5 -156 1951 8 21 10 57 NaN 4 {'definite tsunami' } 1 {'Earthquake' } 6.9 {'USA' } {'HAWAII' } 3.6 1.8 NaN NaN NaN
-9.02 157.95 1951 12 22 NaN NaN NaN 2 {'questionable tsunami' } 6 {'Volcano' } NaN {'SOLOMON ISLANDS'} {'KAVACHI' } 6 2.6 NaN NaN NaN
42.15 143.85 1952 3 4 1 22 41 4 {'definite tsunami' } 1 {'Earthquake' } 8.1 {'JAPAN' } {'SE. HOKKAIDO ISLAND' } 6.5 2.7 2 33 1
19.1 -155 1952 3 17 3 58 NaN 4 {'definite tsunami' } 1 {'Earthquake' } 4.5 {'USA' } {'HAWAII' } 1 NaN NaN NaN NaN
43.1 -82.4 1952 5 6 NaN NaN NaN 1 {'very doubtful tsunami'} 9 {'Meteorological'} NaN {'USA' } {'LAKE HURON, MI' } 1.52 NaN NaN NaN NaN
52.75 159.5 1952 11 4 16 58 NaN 4 {'definite tsunami' } 1 {'Earthquake' } 9 {'RUSSIA' } {'KAMCHATKA' } 18 4.2 4 2236 3
50 156.5 1953 3 18 NaN NaN NaN 3 {'probable tsunami' } 1 {'Earthquake' } 5.8 {'RUSSIA' } {'N. KURIL ISLANDS' } 1.5 0.6 NaN NaN NaN
: : : : : : : : : : : : : : : : : : : :
: : : : : : : : : : : : : : : : : : : :
将 Year、Month、Day、Hour、Minute 和 Second 变量合并为单一 datetime 变量,然后从该表中删除这些变量。删除所有包含缺失数据的行。
T.DateTime = datetime(T.Year, T.Month, T.Day, T.Hour, T.Minute, T.Second);
T(:,3:8) = [];
TT = rmmissing(T)
TT =

  M×15 tall table

    Latitude    Longitude    ValidityCode          Validity          CauseCode               Cause                EarthquakeMagnitude       Country                 Location              MaxHeight    IidaMagnitude    Intensity    NumDeaths    DescDeaths          DateTime
    ________    _________    ____________    ____________________    _________    ____________________________    ___________________    _____________    ____________________________    _________    _____________    _________    _________    __________    ____________________

     42.15        143.85          4          {'definite tsunami'}        1        {'Earthquake'              }            8.1            {'JAPAN'    }    {'SE. HOKKAIDO ISLAND'     }        6.5           2.7              2           33           1         04-Mar-1952 01:22:41
     58.34       -136.52          4          {'definite tsunami'}        3        {'Earthquake and Landslide'}            8.3            {'USA'      }    {'SE. ALASKA, AK'          }     524.26           4.6              5            5           1         10-Jul-1958 06:15:53
     -39.5         -74.5          4          {'definite tsunami'}        1        {'Earthquake'              }            9.5            {'CHILE'    }    {'CENTRAL CHILE'           }         25           4.6              4         1260           3         22-May-1960 19:11:17
      -6.8         -80.7          4          {'definite tsunami'}        1        {'Earthquake'              }            6.8            {'PERU'     }    {'PERU'                    }          9           3.2            2.5           66           2         20-Nov-1960 22:01:56
      61.1        -147.5          4          {'definite tsunami'}        3        {'Earthquake and Landslide'}            9.2            {'USA'      }    {'PRINCE WILLIAM SOUND, AK'}         67           6.1              5          221           3         28-Mar-1964 03:36:14
     38.65         139.2          4          {'definite tsunami'}        1        {'Earthquake'              }            7.5            {'JAPAN'    }    {'NW. HONSHU ISLAND'       }        5.8           2.7              2           26           1         16-Jun-1964 04:01:44
       0.2         119.8          4          {'definite tsunami'}        1        {'Earthquake'              }            7.8            {'INDONESIA'}    {'BANDA SEA'               }         10           3.3              3          200           3         14-Aug-1968 22:14:19
      -3.1         118.9          4          {'definite tsunami'}        1        {'Earthquake'              }            6.9            {'INDONESIA'}    {'MAKASSAR STRAIT'         }          4             2              2          600           3         23-Feb-1969 00:36:56
       :            :             :                   :                  :                     :                           :                   :                       :                      :              :              :            :            :                  :
       :            :             :                   :                  :                     :                           :                   :                       :                      :              :              :            :            :                  :
将表作为电子表格文件写入 Amazon S3™ 存储中的一个远程位置。要在 Amazon S3 中读取或写入数据,必须使用您帐户的凭据设置 AWS_ACCESS_KEY_ID 和 AWS_SECRET_ACCESS_KEY 环境变量。有关详细信息,请参阅处理远程数据。
setenv('AWS_ACCESS_KEY_ID', 'YOUR_AWS_ACCESS_KEY_ID');
setenv('AWS_SECRET_ACCESS_KEY', 'YOUR_AWS_SECRET_ACCESS_KEY');

location = 's3://bucketname/preprocessedData/';
write(location, TT, 'FileType', 'spreadsheet')
要读回数据,请使用 datastore 指向数据现在所在的远程位置。
ds = datastore(location);
tt = tall(ds);
创建并使用一个自定义写函数,以 write 不直接支持的其他格式(如图像文件)写入数据。
创建一个引用当前示例文件夹中所有示例图像的图像数据存储。所选图像的扩展名为 .jpg、.tif 和 .png。将数据存储转换为 tall 元胞数组。
currentFolder = pwd;
ds = imageDatastore(currentFolder,FileExtensions=[".jpg" ".tif" ".png"]);
T = tall(ds);
将其中一个图像存入内存并显示它。
I = gather(T(1));
Evaluating tall expression using the Parallel Pool 'Processes':
- Pass 1 of 1: Completed in 0.71 sec
Evaluation completed in 0.98 sec
imshow(I{1})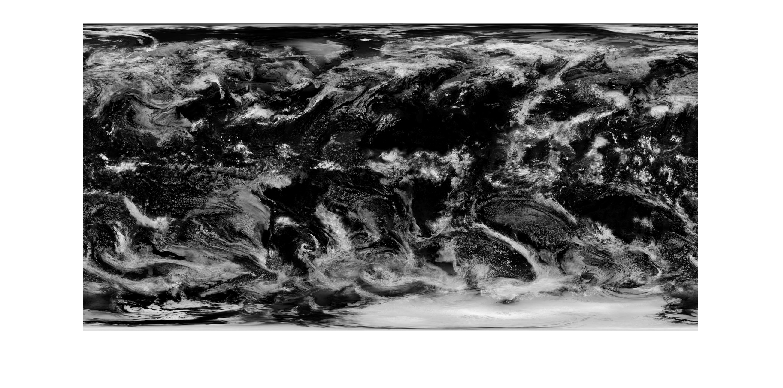
write 不直接支持图像文件,因此要以不同格式写入图像,您必须创建新函数来处理文件写入。写函数从 write: 接收两个输入
info是一个结构体,其中包含有关当前数据块信息的字段。您可以使用这些字段构造自己的唯一文件名,或者只使用SuggestedFilename字段来使用write建议的名称。data是当前数据块,通过对数据存储使用read获得。
函数 imageWriter 使用 write 建议的文件名,并使用 imwrite 将图像文件作为 .jpg 文件写入磁盘。将此函数保存在当前工作文件夹中。
type imageWriterfunction imageWriter(info, data)
filename = info.SuggestedFilename;
imwrite(data{:}, filename)
end
将数据存储中的图像写入 C:\ 磁盘上名为 exampleImages 的新文件夹。(您可以使用其他位置,尤其是在您不使用 Windows® 计算机的情况下。)使用 WriteFcn 名称-值对组参量将 imageWriter 作为自定义写函数传递。
location = "C:\exampleImages\image_*.jpg";
write(location,T,WriteFcn=@imageWriter)
Writing tall data to folder C:\exampleImages Evaluating tall expression using the Parallel Pool 'Processes': - Pass 1 of 1: Completed in 0.59 sec Evaluation completed in 1.5 sec
显示写入文件的文件夹的内容。
dir C:\exampleImages. .. image_1_000001.jpg image_2_000001.jpg
要将图像读回 MATLAB® 中,请创建引用相同位置的数据存储。
ds = imageDatastore(location);
T = tall(ds)
T =

  2×1 tall cell array

    {1024×2048×3 uint8}
    {1024×2048×3 uint8}
输入参数
名称-值参数
限制
在某些情况下,write(location, T, 'FileType', type) 创建的文件并不能准确表示原始数组 T。如果使用 datastore(location) 来读取文件,则结果可能与原始 tall 表的格式或内容不完全相同。
对于
'text'和'spreadsheet'文件类型,write使用以下规则:write使用longG格式输出数值变量,并将分类、字符或字符串变量输出为不带引号的文本。对于具有多个列的非文本变量,
write在每行上输出多个以分隔符分隔的字段,并为文件的第一行构造合适的列标题。write将具有两个以上维度的变量输出为二维变量,即折叠尾部维度。对于具有数值、逻辑值、字符或分类内容的元胞值变量,
write输出到以分隔符分隔的多个字段中(每个元胞的内容作为一行)。如果元胞具有不同数据类型,write将输出单一空字段。
如果需要写 tall 数组的一个精确检查点,请不要使用
'text'或'spreadsheet'文件类型。对于
'parquet'文件类型,有些情况下 Parquet 格式无法完整表示 MATLAB 表或时间表数据类型。如果使用parquetread或datastore来读取文件,则结果可能与原始 tall 表的格式或内容不完全相同。有关详细信息,请参阅Apache Parquet Data Type Mappings。
提示
使用
write函数可在您工作时创建数据的检查点或快照,尤其是处理巨型数据集时。这样可以直接基于磁盘上的文件重新构造 tall 数组,而不用重新执行生成该 tall 数组的所有命令。
扩展功能
版本历史记录
在 R2016b 中推出

