主要内容

histcounts2

R2026b

二元直方图箱计数

描述

[N,Xedges,Yedges] = histcounts2(X,Y) 将 X 和 Y 中的值划分为多个二维箱,并返回箱计数以及每个维度的箱边界。histcounts2 函数使用自动分箱算法,然后返回均匀箱,这些箱可涵盖 X 和 Y 中值的范围并显示分布的基本形状。

示例

[N,Xedges,Yedges] = histcounts2(X,Y,nbins) 指定要在每个维度中使用的箱数。

示例

[N,Xedges,Yedges] = histcounts2(X,Y,Xedges,Yedges) 按照 Xedges 和 Yedges 指定的箱边界,将 X 和 Y 划分为多个箱。

示例

[N,Xedges,Yedges] = histcounts2(___,Name,Value) 使用一个或多个名称-值参量为上述任一语法指定其他参数。例如,将 BinWidth 指定为一个二元素向量来调整每个维度中箱的宽度。

示例

[N,Xedges,Yedges,binX,binY] = histcounts2(___) 还返回 X 和 Y 中对应元素的箱索引。

示例

示例

全部折叠

将 100 个随机数对组分布到多个箱内。histcounts2 自动选择合适的箱宽度以显示数据的基本分布。

x = randn(100,1);
y = randn(100,1);
[N,Xedges,Yedges] = histcounts2(x,y)
N = 7×6

     0     0     0     2     0     0
     1     2    10     4     0     0
     1     4     9     9     5     0
     1     4    10    11     5     1
     1     4     6     3     1     1
     0     0     1     2     0     0
     0     0     1     0     1     0

Xedges = 1×8

    -3    -2    -1     0     1     2     3     4

Yedges = 1×7

    -3    -2    -1     0     1     2     3

将 10 个数字对组分布到 12 个箱中。在 x 维度指定 3 个箱,在 y 维度指定 4 个箱。

x = [1 1 2 3 2 2 1 1 2 3];
y = [5 6 3 8 9 1 2 7 5 1];
nbins = [3 4];
[N,Xedges,Yedges] = histcounts2(x,y,nbins)
N = 3×4

     1     0     2     1
     1     1     1     1
     1     0     0     1

Xedges = 1×4

    0.6000    1.4000    2.2000    3.0000

Yedges = 1×5

         0    2.3000    4.6000    6.9000    9.2000

将 1,000 个随机数对组分布到多个箱内。使用两个向量(分别针对 x 和 y 维度)定义箱边界。每个向量中的第一个元素指定第一个箱的第一个边界,最后一个元素指定最后一个箱的最后一个边界。

x = randn(1000,1);
y = randn(1000,1);
Xedges = -5:5;
Yedges = [-5 -4 -2 -1 -0.5 0 0.5 1 2 4 5];
N = histcounts2(x,y,Xedges,Yedges)
N = 10×10

     0     0     0     0     0     0     0     0     0     0
     0     0     0     0     1     1     1     0     0     0
     0     0     5     5     3     5     1     2     0     0
     0     2    19    23    29    25    26    20     5     0
     0    10    36    51    59    71    54    46    10     0
     0     7    43    46    79    64    60    46     9     0
     0     3    12    18    21    23    19     9     6     0
     0     0     5     3     2     8     2     2     0     0
     0     0     0     1     1     1     0     0     0     0
     0     0     0     0     0     0     0     0     0     0

将 1,000 个随机数对组分布到多个箱内。将 Normalization 指定为 'probability' 以对箱计数进行归一化处理,从而 sum(N(:)) 为 1。即,每个箱计数代表观测值属于该箱的可能性。

x = randn(1000,1);
y = randn(1000,1);
[N,Xedges,Yedges] = histcounts2(x,y,6,'Normalization','probability')
N = 6×6

         0         0    0.0020    0.0020         0         0
         0    0.0110    0.0320    0.0260    0.0070    0.0010
    0.0010    0.0260    0.1410    0.1750    0.0430    0.0060
         0    0.0360    0.1620    0.1940    0.0370    0.0040
         0    0.0040    0.0300    0.0370    0.0100    0.0010
         0    0.0030    0.0040    0.0040    0.0010         0

Xedges = 1×7

   -4.0000   -2.7000   -1.4000   -0.1000    1.2000    2.5000    3.8000

Yedges = 1×7

   -4.0000   -2.7000   -1.4000   -0.1000    1.2000    2.5000    3.8000

将介于 -10 和 10 之间的 1000 个随机整数对组分布到多个箱内,并将 BinMethod 指定为 'integers' 以使用以整数为中心的单位宽度箱。指定 histcounts2 的五个输出以返回表示数据箱位置的向量。

x = randi([-10,10],1000,1);
y = randi([-10,10],1000,1);
[N,Xedges,Yedges,binX,binY] = histcounts2(x,y,'BinMethod','integers');

确定值 (x(3),y(3)) 属于哪个箱。

[x(3),y(3)]
ans = 1×2

    -8    10

bin = [binX(3) binY(3)]
bin = 1×2

     3    21

输入参数

全部折叠

要分布到各箱的数据,指定为向量、矩阵或多维数组的单独参量。X 和 Y 的大小必须相同。

X 和 Y 中的对应元素指定二维数据点 [X(k),Y(k)] 的 x 和 y 坐标。X 和 Y 的数据类型可以不同。

histcounts2 忽略所有的 NaN 值。同样,histcounts2 忽略 Inf 和 -Inf 值,除非箱边界将 Inf 或 -Inf 显式指定为箱边界。

数据类型: single | double | int8 | int16 | int32 | int64 | uint8 | uint16 | uint32 | uint64 | logical

每个维度中的箱数,指定为一个正整数标量或由正整数组成的二元素向量。

  • 如果 nbins 是标量,则 histcounts2 在每个维度中使用该标量所指定的箱数。

  • 如果 nbins 是向量,则第一个元素给出 x 维度中的箱数,第二个元素给出 y 维度中的箱数。

如果不指定 nbins,则 histcounts2 自动基于 X 和 Y 中的值计算要使用多少个箱。

如果用 BinMethod 或 BinWidth 指定 nbins,则 histcounts2 仅采用最后一个参数。

示例: [N,Xedges,Yedges] = histcounts2(X,Y,15) 在 x 维度和 y 维度使用 15 个箱。

示例: [N,Xedges,Yedges] = histcounts2(X,Y,[15 20]) 在 x 维度使用 15 个箱,在 y 维度使用 20 个箱。

x 维度中的箱边界,指定为向量。第一个元素指定 x 维度中第一个箱的左边界。最后一个元素指定 x 维度中的最后一个箱的右边界。仅最后一个箱包含右边界。

  • 如果用 BinMethod、BinWidth 或 NumBins 指定 Xedges 和 Yedges,histcounts2 只采用箱边界且箱边界必须最后指定。

  • 如果用 XBinLimits 指定 Xedges,则 histcounts2 仅采用 Xedges 且 Xedges 必须最后指定。

y 维度中的箱边界,指定为向量。第一个元素指定 y 维度中第一个箱的左边界。最后一个元素指定 y 维度中的最后一个箱的右边界。仅最后一个箱包含右边界。

  • 如果用 BinMethod、BinWidth 或 NumBins 指定 Yedges 和 Xedges,histcounts2 只采用箱边界且箱边界必须最后指定。

  • 如果用 YBinLimits 指定 Yedges,则 histcounts2 仅采用 Yedges 且 Yedges 必须最后指定。

名称-值参数

全部折叠

将可选参量对组指定为 Name1=Value1,...,NameN=ValueN,其中 Name 是参量名称,Value 是对应的值。名称-值参量必须出现在其他参量之后,但对各个参量对组的顺序没有要求。

如果使用的是 R2021a 之前的版本,请使用逗号分隔每个名称和值,并用引号将 Name 引起来。

示例: [N,Xedges,Yedges] = histcounts2(X,Y,'Normalization','probability') 对 N 中的箱计数进行归一化,这样 sum(N) 为 1。

每个维度中的箱宽度,指定为由正值组成的二元素向量。第一个元素为 x 维度中的箱宽度,第二个元素为 y 维度中的箱宽度。

如果指定 BinWidth,则 histcounts2 可以沿每个维度使用最多 1024 (210) 个箱。如果指定的箱宽度需要多个箱,则 histcounts2 使用与最大箱数对应的较大的箱宽度。

如果用 BinMethod 或 NumBins 指定 BinWidth,则 histcounts2 仅采用最后一个参数。

示例: histcounts2(X,Y,'BinWidth',[5 10]) 在 x 维度使用的箱的大小为 5,在 y 维度使用的箱的大小为 10。

x 维度的箱范围,指定为二元素向量 [xbmin,xbmax]。第一个元素指示 x 维度中的第一个箱边界。第二个元素指示 x 维度中的最后一个箱边界。

此选项只对在箱范围 X>=xbmin & X<=xbmax(包含这两个边界值)内的数据分箱。

y 维度的箱范围,指定为二元素向量 [ybmin,ybmax]。第一个元素指示 y 维度中的第一个箱边界。第二个元素指示 y 维度中的最后一个箱边界。

此选项只对在箱范围 Y>=ybmin & Y<=ybmax(包含这两个边界值)内的数据分箱。

分箱算法,指定为此表中的一个值。

值描述
'auto'

默认的 'auto' 算法选择一个箱宽度,以便涵盖数据范围并显示基础分布形状。

'scott'

如果数据接近联合正态分布,则斯科特规则最佳。该规则也适用于大多数的其他分布。它使用箱大小 [3.5*std(X(:))*numel(X)^(-1/4), 3.5*std(Y(:))*numel(Y)^(-1/4)]。

'fd'

弗里德曼-迪亚科尼斯规则对数据中的离群值不太敏感,可能更适用于重尾分布的数据。它使用的箱大小为 [2*iqr(X(:))*numel(X)^(-1/4), 2*iqr(Y(:))*numel(Y)^(-1/4)];如果 X 包含极端离群值,则使用 [0.2*(max(X(:))-min(X(:)))*numel(X)^(-1/4), 0.2*(max(Y(:))-min(Y(:)))*numel(Y)^(-1/4)]。

'integers'

整数规则对整数数据有用,因为它创建以整数为中心的箱。它对每个维度使用箱宽度 1 并将箱边界放在整数的中间。

为避免无意间创建太多箱,可以使用此规则创建 1024 (210) 个箱的限制。如果任一维度的数据范围大于 1024,则整数规则改用更宽的箱。

  • histcounts2 稍微调整箱数,使箱边界落在“合适”的数字上,而不是机械遵循这些精确的公式。

  • 如果设置 NumBins、XBinEdges、YBinEdges、BinWidth、XBinLimits 或 YBinLimits 属性,则 BinMethod 设置为 'manual'。

  • 如果用 BinWidth 或 NumBins 指定 BinMethod,则 histcounts2 仅采用最后一个参数。

示例: histcounts2(X,Y,'BinMethod','integers') 以整数为中心放置二维箱。

归一化类型,指定为此表中的一个值。对于每个箱 i:

  • vi 是箱的值。

  • ci 是箱中的元素数目。

  • Ai=wxi⋅wyi 是箱的面积,使用箱宽度 x 和 y 计算得出。

  • N 是输入数据中的元素数目。此值可以大于分箱数据元素数,前提是数据中包含缺失值,或者某些数据位于箱范围外。

值箱值注释
'count'(默认值)

vi=ci

  • 观测值的计数或频率。

  • 箱值之和最多为 numel(X) 和 numel(y)。仅当某些输入数据不在箱中时,bin 值之和才会小于此值。

'probability'

vi=ciN

  • 相对概率。

  • 每个箱中的元素数与输入数据中的总元素数之比最大为 1。

'percentage'

vi=100*ciN

  • 相对百分比。

  • 每个箱中的元素百分比最多为 100。

'countdensity'

vi=ciAi

  • 按箱的面积进行换算的计数或频率。

  • N(end,end) 最多为 numel(X) 和 numel(Y)。

'cumcount'

vi=∑j=1icj

  • 累积计数,或在 x 和 y 两个维度上每个箱及前面所有箱中累积的观测值数量。

  • N(end,end) 最多为 numel(X) 和 numel(Y)。

'pdf'

vi=ciN⋅Ai

  • 概率密度函数的估计值。

  • 箱体积之和最多为 1。

'cdf'

vi=∑j=1i cjN

  • 累积分布函数估算值。

  • N(end,end) 最多为 1。

示例: histcounts2(X,Y,'Normalization','pdf') 使用概率密度函数估计值对数据进行分箱。

输出参量

全部折叠

箱计数,以数组形式返回。

分箱方案包括每个箱的 x 维和 y 维的左边界,以及最后一个箱的 x 维和 y 维的右边界。
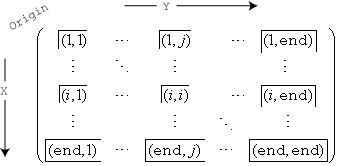
Sample matrix showing the bin inclusion scheme as well as the relative orientation of the bins to the x-axis and y-axis

例如,bin (1,1) 包括位于每个维度中第一个边界上的值,右下角的最后一个箱包括位于其任何边界上的值。

x 维度的箱边界,以向量形式返回。第一个元素是 x 维度中第一个箱的左边界。最后一个元素是 x 维度中最后一个箱的右边界。

y 维度的箱边界,以向量形式返回。第一个元素是 y 维度中第一个箱的左边界。最后一个元素是 y 维度中最后一个箱的右边界。

x 维度中的箱索引,以数组形式返回,数组大小与 X 相同。binX 和 binY 中的对应元素说明哪个编号的箱包含 X 和 Y 中的对应值。binX 和 binY 中的 0 值表示元素不属于任何 bin(例如 NaN 值)。

例如,binX(1) 和 binY(1) 描述值 [X(1),Y(1)] 的箱位置。

y 维度中的箱索引,以数组形式返回,数组大小与 Y 相同。binX 和 binY 中的对应元素说明哪个编号的箱包含 X 和 Y 中的对应值。binX 和 binY 中的 0 值表示元素不属于任何 bin(例如 NaN 值)。

例如,binX(1) 和 binY(1) 描述值 [X(1),Y(1)] 的箱位置。

扩展功能

全部展开

版本历史记录

在 R2015b 中推出

全部展开