主要内容

scatterhistogram

R2026b

创建带直方图的散点图

  • Scatter plot with histograms

描述

scatterhistogram(tbl,xvar,yvar) 基于表 tbl 创建一个边缘带直方图的散点图。xvar 输入参数指示沿 x 轴显示的表变量。yvar 输入参数指示沿 y 轴显示的表变量。

示例

scatterhistogram(tbl,xvar,yvar,'GroupVariable',grpvar) 使用 grpvar 指定的表变量对 xvar 和 yvar 指定的观测值进行分组。

示例

scatterhistogram(xvalues,yvalues) 创建 xvalues 和 yvalues 数据的散点图,并沿 x 轴和 y 轴的边缘分别显示 xvalues 和 yvalues 数据的直方图。

示例

scatterhistogram(xvalues,yvalues,'GroupData',grpvalues) 使用 grpvalues 中的数据对 xvalues 和 yvalues 中的数据进行分组。

示例

scatterhistogram(___,Name,Value) 使用一个或多个名称-值对组参量指定边缘带直方图的散点图的其他选项。请在所有其他输入参量之后指定这些选项。有关属性列表,请参阅 ScatterHistogramChart 属性。

示例

scatterhistogram(parent,___) 在由 parent 指定的图窗、面板或选项卡上创建边缘带直方图的散点图。

s = scatterhistogram(___) 返回 ScatterHistogramChart 对象。创建对象后,使用 s 修改该对象。有关属性列表,请参阅 ScatterHistogramChart 属性。

示例

示例

全部折叠

基于医疗患者数据表创建边缘带直方图的散点图。

加载 patients 数据集,并基于加载到工作区中的变量子集创建一个表。然后,创建一个散点直方图,用于将 Height 值与 Weight 值进行比较。

load patients
tbl = table(LastName,Age,Gender,Height,Weight);
s = scatterhistogram(tbl,'Height','Weight');
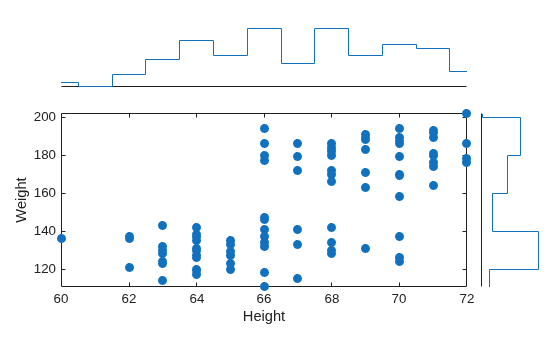
Figure contains an object of type scatterhistogram.

使用 patients 数据集,创建一个边缘带直方图的散点图,并指定用于对数据进行分组的表变量。

加载 patients 数据集并基于数据创建一个散点直方图。比较患者的 Systolic 和 Diastolic 值。通过将 'GroupVariable' 名称-值对组参量设置为 'Smoker',根据患者的吸烟者状态对数据进行分组。

load patients
tbl = table(LastName,Diastolic,Systolic,Smoker);
s = scatterhistogram(tbl,'Diastolic','Systolic','GroupVariable','Smoker');
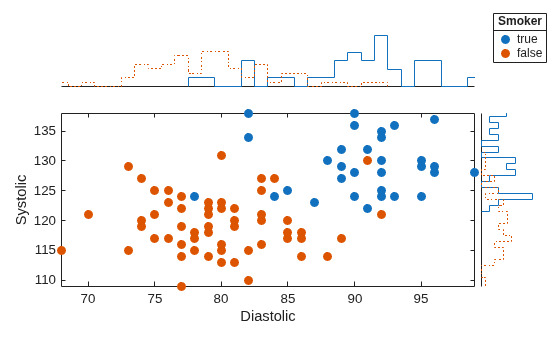
Figure contains an object of type scatterhistogram.

使用边缘带直方图的散点图,以可视方式呈现分类医疗数据和数值医疗数据。

加载 patients 数据集,并将 Smoker 数据转换为分类数组。然后,创建一个散点直方图,用于将患者的 Age 值与其吸烟者状态进行比较。生成的散点图包含重叠的数据点。然而,y 轴边缘直方图指示数据集中的非吸烟者远远多于吸烟者。

load patients
Smoker = categorical(Smoker);
s = scatterhistogram(Age,Smoker);
xlabel('Age')
ylabel('Smoker')
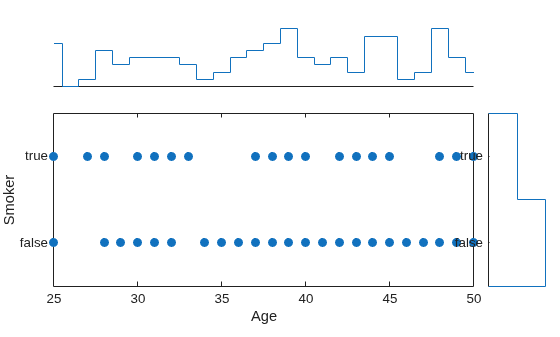
Figure contains an object of type scatterhistogram.

使用鞋数据的数组创建一个边缘带直方图的散点图。根据鞋的颜色对数据进行分组,并自定义散点直方图的属性。

创建数据数组。然后,创建一个散点直方图以可视化数据。沿 x 轴和 y 轴使用自定义标签指定前两个输入参量的变量名称。您可以通过设置 ScatterHistogramChart 对象的属性来指定标题、轴标签和图例标题。

xvalues = [7 6 5 6.5 9 7.5 8.5 7.5 10 8];
yvalues = categorical({'onsale','regular','onsale','onsale', ...
    'regular','regular','onsale','onsale','regular','regular'});
grpvalues = {'Red','Black','Blue','Red','Black','Blue','Red', ...
    'Red','Blue','Black'};
s = scatterhistogram(xvalues,yvalues,'GroupData',grpvalues, ...
    LegendVisible = "on");

s.Title = 'Shoe Sales';
s.XLabel = 'Shoe Size';
s.YLabel = 'Price';
s.LegendTitle = 'Shoe Color';

更改散点直方图中的颜色以匹配分组标签。更改直方图中的箱宽度,便每个组的箱宽度都相同。

s.Color = {'Red','Black','Blue'};
s.BinWidths = 1;
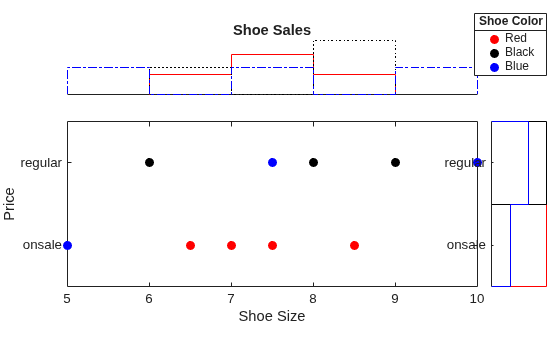
Figure contains an object of type scatterhistogram. The chart of type scatterhistogram has title Shoe Sales.

创建一个边缘带直方图的散点图。指定直方图的箱数和线宽、散点图的位置以及图例可见性。

加载 patients 数据集并基于数据创建一个散点直方图。比较患者的 Diastolic 和 Systolic 值,并根据患者的 SelfAssessedHealthStatus 值对数据进行分组。通过指定 NumBins 和 LineWidth 选项来调整直方图。使用 ScatterPlotLocation 选项将散点图放在图窗的 'NorthEast' 位置。通过将 LegendVisible 选项指定为 'on',确保图例可见。

load patients
tbl = table(LastName,Diastolic,Systolic,SelfAssessedHealthStatus);
s = scatterhistogram(tbl,'Diastolic','Systolic','GroupVariable','SelfAssessedHealthStatus', ...
    'NumBins',4,'LineWidth',1.5,'ScatterPlotLocation','NorthEast','LegendVisible','on');
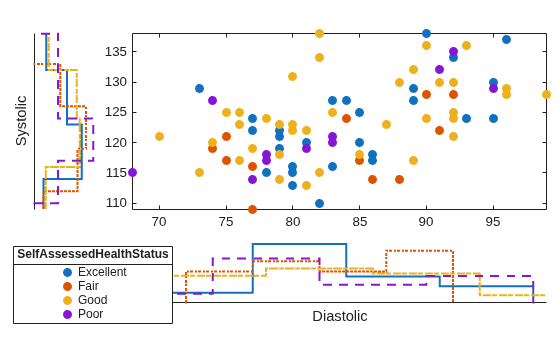
Figure contains an object of type scatterhistogram.

创建一个边缘带直方图的散点图。使用两个不同变量的组合对数据进行分组。

加载 patients 数据集。合并 Smoker 和 Gender 数据以创建一个新变量。创建一个散点直方图,用于比较患者的 Diastolic 和 Systolic 值。使用新变量 SmokerGender 对散点直方图中的数据进行分组。

load patients
[idx,genderStatus,smokerStatus] = findgroups(string(Gender),string(Smoker));
SmokerGender = strcat(genderStatus(idx),"-",smokerStatus(idx));
s = scatterhistogram(Diastolic,Systolic,'GroupData',SmokerGender,'LegendVisible','on');
xlabel('Diastolic')
ylabel('Systolic')
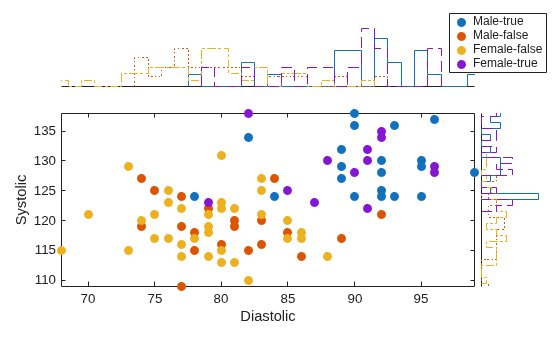
Figure contains an object of type scatterhistogram.

创建一个边缘带核密度直方图的散点图。

加载 patients 数据集。基于 Diastolic、Systolic 和 Smoker 变量创建一个表。

load patients.mat
tbl = table(Diastolic,Systolic,Smoker);

创建一个散点直方图,用于比较患者的 Diastolic 和 Systolic 压力值。使用患者吸烟状态对数据进行分组,并显示边缘核密度图。该图显示与非吸烟者相比吸烟者的平均收缩压和舒张压更高。

s = scatterhistogram(tbl,"Diastolic","Systolic", ...
    GroupVariable="Smoker",HistogramDisplayStyle="smooth", ...
    LineStyle="-");
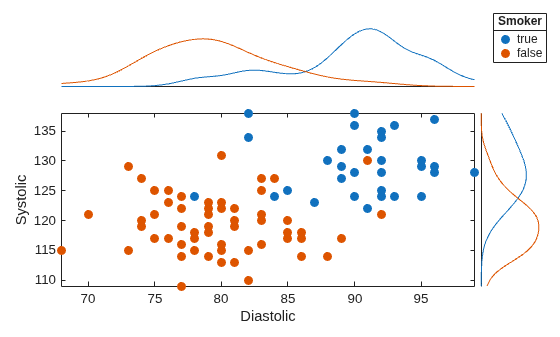
Figure contains an object of type scatterhistogram.

输入参数

全部折叠

源表,指定为表。

您可以使用 table 函数根据工作区变量创建表,也可以使用 readtable 函数以表的形式导入数据。

源表存储在 ScatterHistogramChart 对象的 SourceTable 属性中。

x 轴的表变量,指定为下列形式之一:

  • 字符向量或字符串标量 - 指示变量名称之一。例如,scatterhistogram(tbl,'Acceleration','Horsepower') 为 x 轴选择名为 'Acceleration' 的变量。

  • 数值标量 - 指示表变量索引。例如,scatterhistogram(tbl,5,3) 为 x 轴选择表中的第五个变量。

  • 逻辑向量 - 包含一个 true 元素。

与表变量关联的值必须为数值类型或 categorical 类型。

ScatterHistogramChart 对象的 XVariable 属性存储选定变量的名称。

y 轴的表变量,指定为下列形式之一:

  • 字符向量或字符串标量 - 指示变量名称之一。例如,scatterhistogram(tbl,'Acceleration','Horsepower') 为 y 轴选择名为 'Horsepower' 的变量。

  • 数值标量 - 指示表变量索引。例如,scatterhistogram(tbl,5,3) 为 y 轴选择表中的第三个变量。

  • 逻辑向量 - 包含一个 true 元素。

与表变量关联的值必须为数值类型或 categorical 类型。

ScatterHistogramChart 对象的 YVariable 属性存储选定变量的名称。

用于对数据分组的表变量,指定为下列形式之一:

  • 字符向量或字符串标量 - 指示变量名称之一

  • 数值标量 - 指示表变量索引

  • 逻辑向量 - 包含一个 true 元素

与表变量关联的值必须构成一个数值向量、逻辑向量、分类数组、字符串数组或字符向量元胞数组。

grpvar 将 xvar 和 yvar 中的数据拆分为具有唯一性的组。每个组在每个轴上都有默认颜色和独立的直方图。在图例中,scatterhistogram 按照组在 GroupData 中首次出现的顺序显示其组名称。

示例: 'Model_Year'

示例: 2

显示在 x 轴上的值,指定为数值向量或分类数组。

ScatterHistogramChart 对象的 XData 属性存储 xvalues 数据。

示例: [0.5 4.3 2.4 5.6 3.4]

示例: categorical({'small','medium','small','large','medium','small'})

显示在 y 轴上的值,指定为数值向量或分类数组。

ScatterHistogramChart 对象的 YData 属性存储 yvalues 数据。

示例: [0.5 4.3 2.4 5.6 3.4]

示例: categorical({'small','medium','small','large','medium','small'})

散点图和对应的边缘直方图的组值,指定为数值向量、逻辑向量、分类数组、字符串数组或字符向量元胞数组。

grpvalues 将 xvalues 和 yvalues 中的数据拆分为具有唯一性的组。每个组在每个轴上都有默认颜色和独立的直方图。在图例中,scatterhistogram 按照组在 GroupData 中首次出现的顺序显示其组名称。

示例: [1 2 1 3 2 1 3]

示例: categorical({'blue','green','green','blue','green'})

父容器,指定为 Figure、Panel、Tab、TiledChartLayout 或 GridLayout 对象。

名称-值参数

全部折叠

将可选参量对组指定为 Name1=Value1,...,NameN=ValueN,其中 Name 是参量名称,Value 是对应的值。名称-值参量必须出现在其他参量之后,但对各个参量对组的顺序没有要求。

如果使用的是 R2021a 之前的版本,请使用逗号分隔每个名称和值,并用引号将 Name 引起来。

示例: scatterhistogram(tbl,xvar,yvar,'GroupVariable',grpvar,'HistogramDisplayStyle','stairs') 将 grpvar 指定为分组变量,并在散点图旁边显示阶梯图。

注意

此处所列的属性只是一部分。有关完整列表,请参阅 ScatterHistogramChart 属性。

图标题,指定为字符向量、字符串数组、字符向量元胞数组或分类数组。默认图没有标题。

要创建一个多行标题,请指定字符串数组或字符向量元胞数组。数组中的每个元素对应一行文本。

如果将标题指定为分类数组,MATLAB® 将使用数组中的值,而不是类别。

示例: s = scatterhistogram(__,'Title','My Title Text')

示例: s.Title = 'My Title Text'

示例: s.Title = {'My','Title'}

直方图箱数,指定为正整数标量、2×1 正整数向量或 2×n 正整数矩阵,其中 n 为 GroupData 中的组数。

指定的值描述
标量该值是 x 和 y 直方图的箱数。
2×1 向量第一个值是 x 数据的箱数,第二个值是 y 数据的箱数。
2×n 矩阵(1,j) 值是第 j 个组中 x 数据的直方图的箱数。同样,(2,j) 值是第 j 个组中 y 数据的直方图的箱数。

scatterhistogram 使用 histogram 的 'BinMethod','auto' 名称-值对组参量来确定默认 NumBins 和 BinWidths 值。

您不能更改分类数据的 NumBins。

示例: s = scatterhistogram(__,'NumBins',20)

示例: s.NumBins = [10; 15]

直方图显示样式,指定为下列选项之一。

显示样式描述
'stairs'显示阶梯图,该图显示直方图的轮廓而不填充条形。
'bar'显示直方条形图。
'smooth'显示通过核密度估计值生成的平滑图。

scatterhistogram 使用 'pdf' 归一化类型来生成直方图。有关详细信息,请参阅 histogram 的 'Normalization' 名称-值对组参量。

示例: s = scatterhistogram(__,'HistogramDisplayStyle','smooth')

示例: s.HistogramDisplayStyle = 'bar'

直方图线宽,指定为正标量或正向量,以磅为单位。默认情况下,scatterhistogram 为直方图中的每个线条指定 0.5 的线宽。

当组的总数超过指定的线宽数量时,scatterhistogram 将循环使用指定的线宽。

示例: s = scatterhistogram(__,'LineWidth',0.75)

示例: s.LineWidth = [0.5 0.75 0.5]

每个散点图组的标记符号,指定为下列形式之一:

  • 指定标记样式的字符向量

  • 指定一个或多个标记样式的字符串数组或字符向量元胞数组

从这些标记选项中进行选择。

标记描述生成的标记
"o"圆圈

Sample of circle marker

"+"加号

Sample of plus sign marker

"*"星号

Sample of asterisk marker

"."点

Sample of point marker

"x"叉号

Sample of cross marker

"_"水平线条

Sample of horizontal line marker

"|"垂直线条

Sample of vertical line marker

"square"方形

Sample of square marker

"diamond"菱形

Sample of diamond marker

"^"上三角

Sample of upward-pointing triangle marker

"v"下三角

Sample of downward-pointing triangle marker

">"右三角

Sample of right-pointing triangle marker

"<"左三角

Sample of left-pointing triangle marker

"pentagram"五角形

Sample of pentagram marker

"hexagram"六角形

Sample of hexagram marker

"none"无标记不适用

默认情况下,scatterhistogram 为散点图中的每个组指定标记符号 'o'。当组的总数超过指定的符号数量时,scatterhistogram 将循环使用指定的符号。

示例: s = scatterhistogram(__,'MarkerStyle','x')

示例: s.MarkerStyle = {'x','o'}

散点图的位置,指定为以下选项之一。

位置描述
'SouthWest'在散点图的右上方绘制直方图。
'SouthEast'在散点图的左上方绘制直方图。
'NorthEast'在散点图的左下方绘制直方图。
'NorthWest'在散点图的右下方绘制直方图。

示例: s = scatterhistogram(__,'ScatterPlotLocation','NorthEast')

示例: s.ScatterPlotLocation = 'SouthEast'

图例可见性的状态,指定为 'on' 或 'off'。将 LegendVisible 设置为 'on' 会显示图例,设置为 'off' 会隐藏图例。

如果 GroupData 为空 ([]) 或只包含一个组,则 scatterhistogram 不显示图例。否则,scatterhistogram 默认显示图例,除非图例与散点图或边缘直方图重叠。

在图例中,scatterhistogram 按照组在 GroupData 中首次出现的顺序显示其组名称。

示例: s = scatterhistogram(__,'LegendVisible','on')

示例: s.LegendVisible = 'off'

输出参量

全部折叠

ScatterHistogramChart 对象,它是一个独立可视化。创建对象后,使用 s 修改该对象。有关属性列表,请参阅 ScatterHistogramChart 属性。

详细信息

全部折叠

提示

  • 要以交互方式浏览 ScatterHistogramChart 对象中的数据,请使用以下选项。其中一些选项在实时编辑器中不可用。

    • 缩放/平移 - 使用滚轮或 + 和 - 键进行缩放。点击并拖动散点图以进行平移。scatterhistogram 根据当前散点图范围内的数据更新边缘直方图。

    • 数据提示 - 将鼠标悬停在散点图或边缘直方图上以显示数据提示。

  • 如果基于表创建边缘带直方图的散点图,则可以自定义散点图的数据提示。

    • 要在数据提示中添加或删除行,请右键点击散点图上的任意位置,然后指向修改数据提示。然后,选择或取消选择一个变量。

    • 要添加或删除多行,请右键点击图,指向修改数据提示,然后选择更多。然后,通过点击 >> 添加变量,或通过点击 << 删除变量。

版本历史记录

在 R2018b 中推出

全部展开